ინტელექტის დემოკრატიზაცია თუ ფასების აგრესიული დემპინგი? OpenAI-მ GPT-6 Sol და Luna წარადგინა
მოწინავე მოდელის, GPT-6 Astra-ს დებიუტიდან მალევე, OpenAI-მ საკუთარი ეკოსისტემის მასშტაბური გაფართოება დააანონსა: ბაზარზე გამოდის ორი ახალი - GPT-6 Sol და GPT-6 Luna. თუ Astra კომპანიის ტექნოლოგიურ მწვერვალსა და მაქსიმალურ შესაძლებლობებს განასახიერებს, Sol-ისა და Luna-ს გამოჩენა სრულიად განსხვავებულ, მკაფიოდ პრაგმატულ ამოცანას ემსახურება: მოწინავე ინტელექტის მასობრივ კომერციალიზაციასა და ხარჯეფექტიანობის ახალი სტანდარტის დამკვიდრებას.
OpenAI-ის განცხადებით, ახალი მოდელები Astra-ს მსგავსი მეთოდოლოგიითაა გაწვრთნილი, რაც მომხმარებელს საშუალებას აძლევს მიიღოს ფლაგმანური დონის სიზუსტე, კოდირების ხარისხი და კომპიუტერის მართვის უნარები საგრძნობლად დაბალ ფასად. ინფერენსისა და მონაცემთა ქეშირების გაუმჯობესების ხარჯზე, კომპანიამ ტარიფები წინა თაობის (GPT-5.6) სარეკლამო ფასებთან შედარებით პირდაპირ 50%-ით შეამცირა - ნაბიჯი, რომელიც ბაზარზე Anthropic-ის მიერ ცოტა ხნის წინ გამოცხადებული Claude Opus 5.5-ის ფასდაკლების პირდაპირ საპასუხო დარტყმად ფასდება.
ფასების რადიკალური ვარდნა API-ში
ტარიფების განახლება უშუალოდ ასახავს ინფრასტრუქტურულ ოპტიმიზაციას. მილიონ ტოკენზე გათვლილი ახალი ფასები შემდეგნაირად განისაზღვრა:
GPT-6 Sol: შემავალი ტოკენების (input) ფასი $4-დან $2-მდე განახევრდა, ხოლო გამავალი ტოკენების (output) ღირებულება $20-დან $10-მდე შემცირდა (50%-იანი გაიაფება GPT-5.6 Sol-თან შედარებით).
GPT-6 Luna: შემავალი ტოკენები $0.20-ის ნაცვლად $0.10 გახდა, ხოლო გამავალი ტოკენები $1.20-დან $0.50-მდე ჩამოვიდა (50%-იანი გაიაფება GPT-5.6 Luna-სთან შედარებით).
კომპანია ხაზს უსვამს, რომ კომპლექსური, კრიტიკული და უკომპრომისო პროექტებისთვის პირველ არჩევნად კვლავ GPT-6 Astra რჩება, თუმცა ყოველდღიური კორპორატიული ამოცანებისთვის Sol და Luna გაცილებით მომგებიან ალტერნატივას გვთავაზობენ.
პროფესიული ამოცანები და ფაქტობრივი სანდოობა
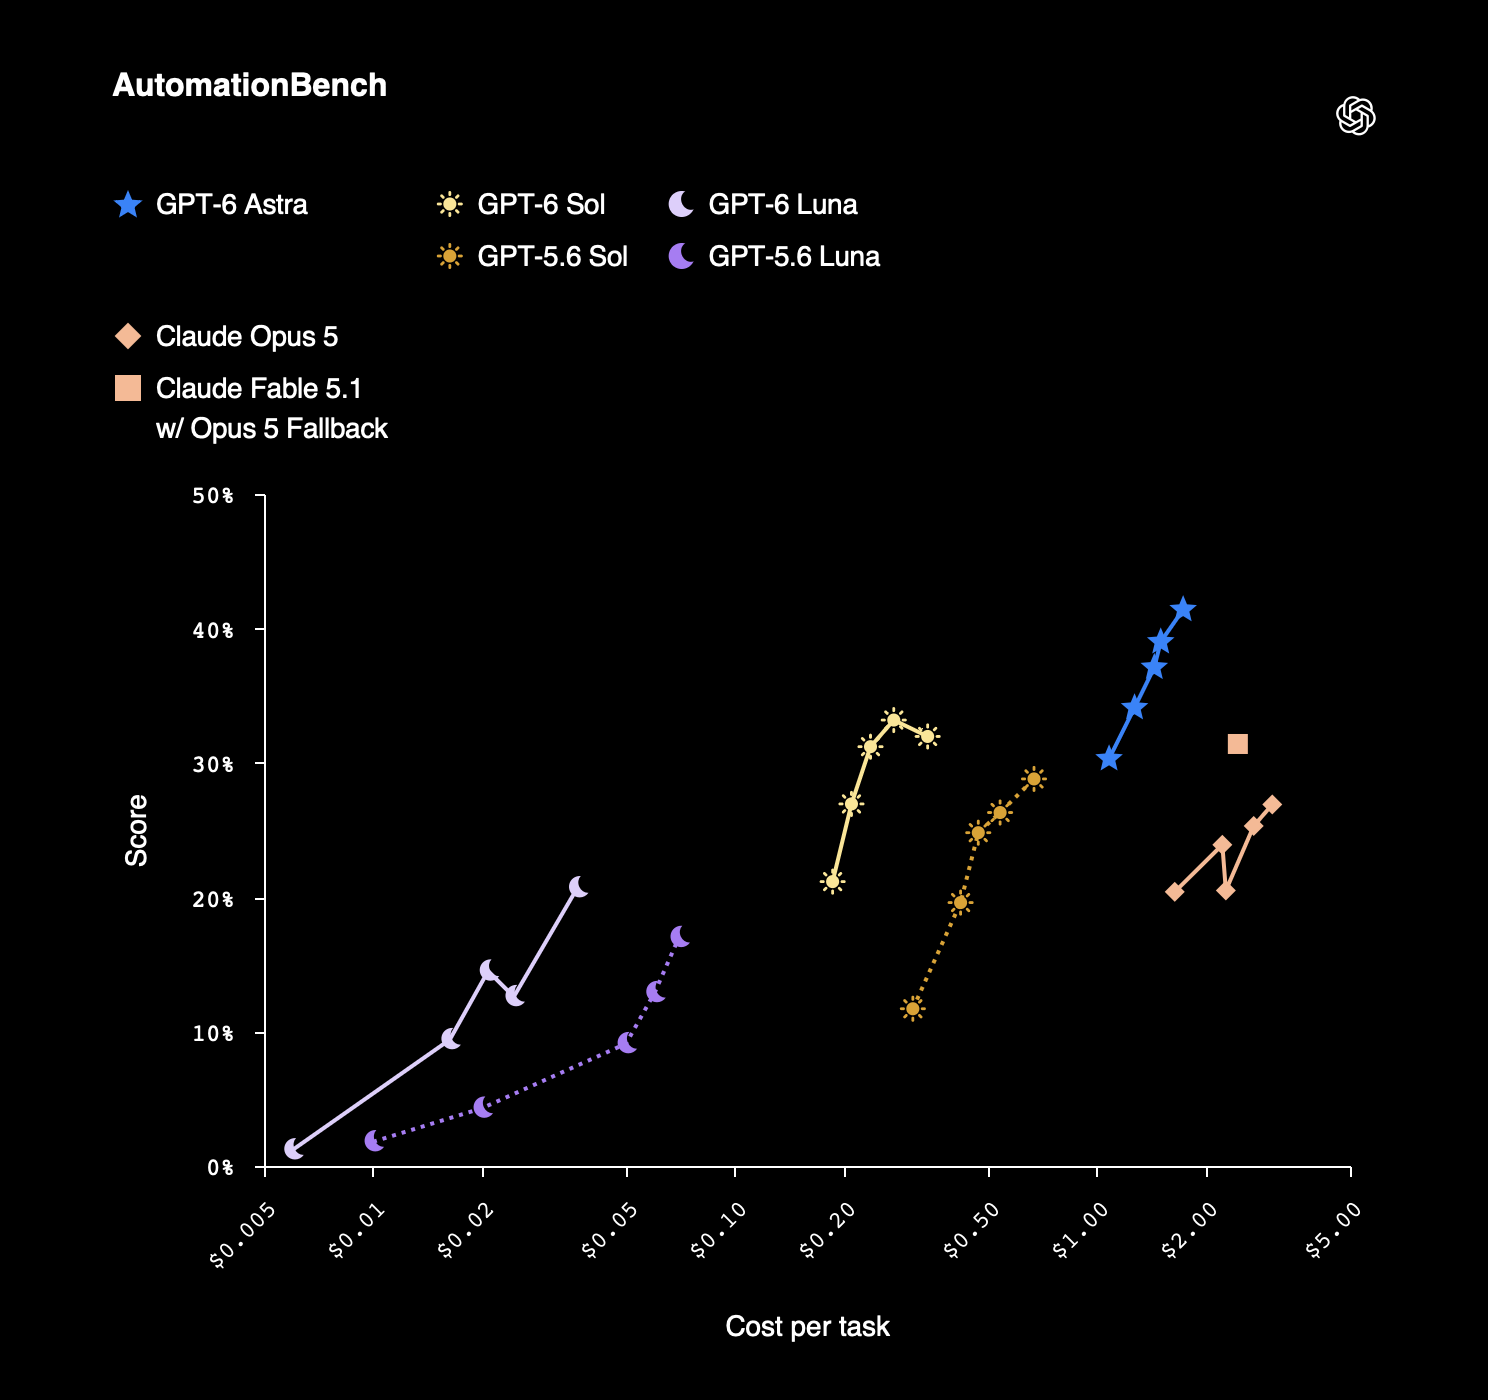
ბიზნესპროცესების ავტომატიზაციის ბენჩმარკზე, AutomationBench, GPT-6 Sol-მა (მაქსიმალურ „xhigh“ დატვირთვაზე) 33.2%-იანი შედეგი აჩვენა და გადაუსწრო Anthropic-ის Claude Opus 5-ს (26.9%), თანაც ისე, რომ თითო ამოცანის შესრულება Opus 5-ის ხარჯის მხოლოდ 9% ($0.27) დაჯდა. Sol-მა ასევე აჯობა Claude Fable 5.1-ს (31.4%) და მცირე დატვირთვაზე მომუშავე GPT-6 Astra-საც კი (30.3%), რომლის თვითღირებულებაც Sol-ზე 3.9-ჯერ მაღალია. ამავე ტესტში GPT-6 Luna-მ წინამორბედთან შედარებით 5.4 პროცენტული პუნქტით უკეთესი შედეგი აჩვენა 58%-ით დაბალი ხარჯით.
რთული კორპორატიული სამუშაოების შეფასებისას (Agents’ Last Exam), GPT-6 Sol-მა მაქსიმალურ რეჟიმში 56.4% დააფიქსირა, რითაც Claude Opus 5-ის პიკურ მაჩვენებელს გადააჭარბა თითო დავალებაზე 60%-ით დაბალი ფასით.
ფაქტობრივი სიზუსტის მხრივ, OpenAI-ის შიდა — რომელიც მომხმარებლების მიერ მოდელის შეცდომებზე მითითებულ რეალურ დიალოგებს ეფუძნება, აჩვენებს, რომ GPT-6 Sol წინამორბედთან შედარებით ორჯერ ნაკლებ შეცდომას უშვებს და საიმედოობით Astra-ს უახლოვდება. პატარა მოდელმა, Luna-მ კი, მაღალი დატვირთვის რეჟიმში GPT-5.6 Sol-ის სიზუსტის დონეს მიაღწია, თუმცა დაახლოებით ასჯერ ნაკლები თვითღირებულებით.
კოდირება და შიდა გამოთვლების რეალობა
პროგრამირების ავტონომიური აგენტების განვითარებასთან ერთად, კოდის გენერაციის ხანგრძლივობამ და მასშტაბმა რადიკალურად მოიმატა. OpenAI საინტერესო შიდა სტატისტიკას ასაჯაროებს: კომპანიის შიგნით, ტარიფებით შეფასებისას, საშუალო (მედიანური) მკვლევრის მიერ მოხმარებული დღიური ტოკენების ღირებულება $600-ს აჭარბებს, ხოლო ყველაზე აქტიური მკვლევრების ტოპ 10%-ისთვის ეს მაჩვენებელი დღეში $7,000-ს შეადგენს. ასეთ მასშტაბებში მოდელის ეკონომიურობა გადამწყვეტ ფაქტორად იქცევა.
რეალურ კოდურ ბაზებზე დაფუძნებულ ტესტში DeepSWE v1.1, GPT-6 Sol-მა მაქსიმალურ რეჟიმში 68.8% მიიღო, რაც თითქმის იმეორებს Claude Fable 5-ის უმაღლეს შედეგს (69.9%), თუმცა 80%-ით იაფად. განსაკუთრებით შთამბეჭდავია GPT-6 Luna-ს მაჩვენებელი: 66.6%-იანი შედეგით ის უტოლდება Claude Opus 5-ისა და Fable 5-ის საშუალო რეჟიმს, მაგრამ Opus-თან შედარებით 93%-ით, ხოლო Fable-თან შედარებით 96%-ით ნაკლები ჯდება.
FrontierCode-ის ბენჩმარკზე Sol-მა მნიშვნელოვნად გააუმჯობესა GPT-5.6-ის შედეგები და Claude Fable 5.1-ს გაუთანაბრდა. კომპიუტერის მართვის ტესტში (OSWorld 2.0 offline), Sol-მა (60.5%) პრაქტიკულად გაიმეორა Claude Opus 5-ის მაჩვენებელი (60.3%) 80%-ით ნაკლები ბიუჯეტით, ხოლო Luna-მ GPT-5.6 Sol-ს ათჯერ ნაკლები ხარჯით აჯობა.
ქეშირების არქიტექტურა და კომუნიკაციის სტილი
ფასების განახლებასთან ერთად, OpenAI-მ მნიშვნელოვნად დახვეწა კონტექსტის მეორადი გამოყენების ( caching) სისტემა. სისტემა ნაგულისხმევად უზრუნველყოფს ქეშის მეტ თანხვედრას (hit rate), რაც ქეშირებული შემავალი ტოკენების წაკითხვაზე 90%-იან ფასდაკლებას იძლევა.
დეველოპერებისთვის ხელმისაწვდომი გახდა ახალი სამართავი პანელი ( Caching Dashboard) და დიაგნოსტიკური ხელსაწყოები. გარდა ამისა, დეველოპერებს უკვე შეუძლიათ შეცვალონ აზროვნების ინტენსივობა (reasoning effort) ან ჩართონ/გამორთონ დამხმარე ხელსაწყოები ქეშის გაწყვეტის გარეშე, და დააწესონ მკაფიო საკვანძო წერტილები (breakpoints), თუ სად უნდა დასრულდეს ქეშირებული პრეფიქსი. GitHub-ის მონაცემებით, ამ ოპტიმიზაციამ ბოლო თვეებში მილიარდობით მოთხოვნაზე 50%-ზე მეტით შეამცირა იმ პრომპტ-ტოკენების წილი, რომლებიც თავიდან დამუშავებას საჭიროებდა, რამაც Copilot-ის რეაქცია საგრძნობლად დააჩქარა.
პარალელურად, მოდელებმა მიიღეს Astra-ს კომუნიკაციური მანერა: ტექსტები გახდა უფრო პირდაპირი, გაიწმინდა ზედმეტი ტექნიკური ჟარგონისა და უსარგებლო დეტალებისგან, პასუხები კი არსის დაკარგვის გარეშე შემოკლდა.
ხელმისაწვდომობა და შეზღუდვები
GPT-6 Sol და GPT-6 Luna უკვე ხელმისაწვდომია ChatGPT Work-სა და Codex-ში Plus, Pro, Business, Enterprise და Edu მომხმარებლებისთვის. უფასო (Free) და Go ტარიფის მომხმარებლები GPT-6 Luna-ზე წვდომას კომპიუტერის (Desktop) აპლიკაციიდან მიიღებენ.
ყურადღებას იქცევს ერთი დეტალი: ახალი მოდელები ამ ეტაპზე არ არის ხელმისაწვდომი სტანდარტულ პირად ჩატში (Chat) — OpenAI მათ მკაფიოდ პოზიციონირებს სამუშაო, აგენტურ და პროგრამულ ინსტრუმენტებად. დეველოპერებისთვის კი -ში მოდელები უკვე გაშვებულია იდენტიფიკატორებით gpt-6-sol და gpt-6-luna. სტაბილურობის შესანარჩუნებლად სისტემა ეტაპობრივად აქტიურდება მომხმარებელთა ანგარიშებზე.