საკუთარი პირველი სპეციალიზებული ჩიპის, Jalapeño-ს ანონსის შემდეგ, OpenAI-მ უშუალოდ აპარატურისა და მის ირგვლივ აგებული სისტემის ტესტირების შედეგები გაასაჯაროვა. მონაცემები კი გასაოგნებელია: ჩიპს ენერგიის თითოეულ ერთეულზე გაცილებით მეტი AI სამუშაოს შესრულება შეუძლია, თანაც ის პასუხებსაც გაცილებით სწრაფად აბრუნებს.
მომხმარებლისთვის ეს ნიშნავს სწრაფ პასუხებს, გაცილებით მოქნილ და რეაქტიულ AI აგენტებს და სტაბილურ წვდომას მზარდი გლობალური მოთხოვნის პირობებშიც კი. OpenAI-ის ოფიციალური მისიაა, ზოგადი (AGI) მთელი კაცობრიობის საკეთილდღეოდ მუშაობდეს. მსგავსი ეფექტიანობა კი მუდმივად მზარდ და მძლავრ სისტემებს უფრო ხელმისაწვდომსა და მასობრივს გახდის.
როგორ ვითარდება Jalapeno
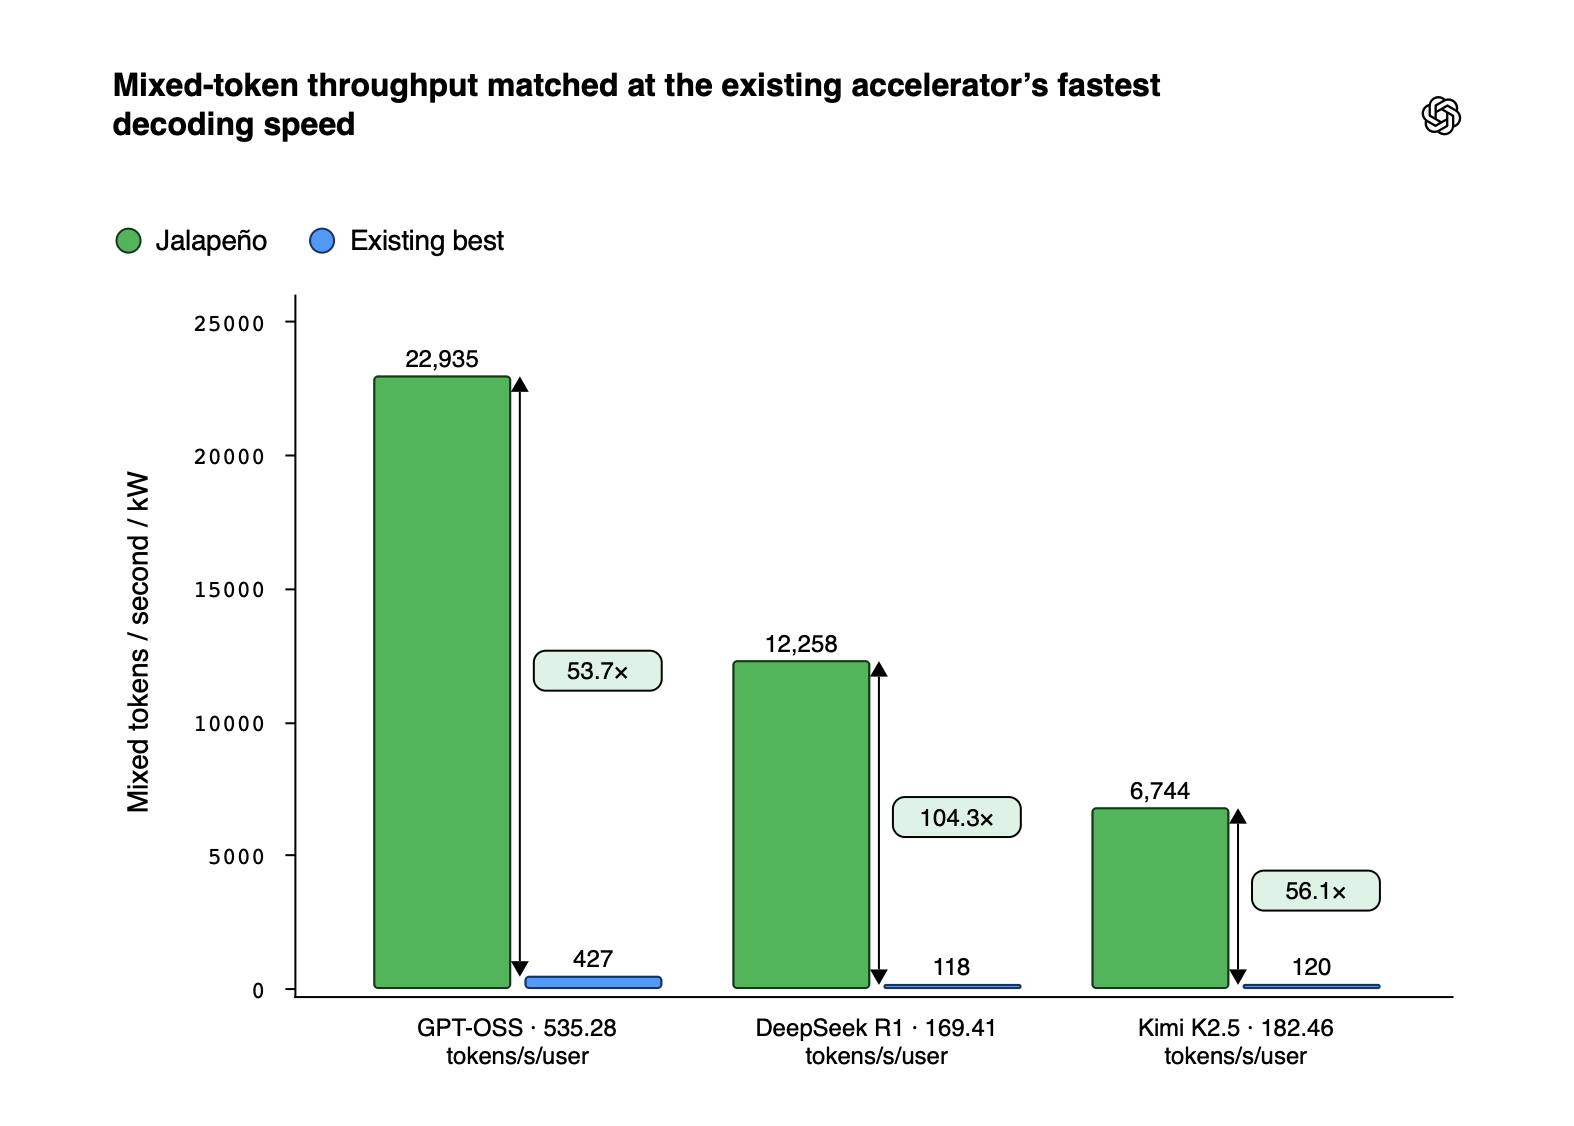
აღსანიშნავია თავად განვითარების პროცესიც. Jalapeño-ს შექმნა თავად OpenAI-ის მოდელებმა დააჩქარეს. წინა თაობები გუნდს ჩიპის დაპროექტებასა და პირველად გაშვებაში ეხმარებოდნენ, ხოლო უახლესი მოდელები მის ოპტიმიზაციასა და დაპროგრამებასაც უზრუნველყოფენ. ამასთან, Jalapeño-ს შესაძლებლობები არ შემოიფარგლება მხოლოდ კომპანიის შიდა არქიტექტურით: ტესტებმა GPT-OSS 120B-ზე, DeepSeek R1-სა და Kimi K2.5 1T-ზე დაადასტურა, რომ სისტემა თანაბრად ეფექტურად მუშაობს როგორც შიდა, ისე გარე მოდელებზე. სამივე შემთხვევაში, შედარებულ სისტემებთან მიმართებით, Jalapeño-მ პიკური გამტარუნარიანობისას ვატზე 1.5-დან 1.9-ჯერ მეტი სამუშაო შეასრულა, ხოლო სრული ციკლის (end-to-end) დაყოვნება 1.7-დან 3.6-ჯერ შეამცირა. მაღალი ინტერაქციულობის მქონე დატვირთვებისას კი წარმადობა 2.1-დან 4.1-ჯერ გაიზარდა.
ეს მონაცემები ცხადყოფს ე.წ. Full-Stack (სრული ეკოსისტემური) მიდგომის უპირატესობას. OpenAI-ს საშუალება აქვს მოდელები, საბოლოო პროდუქტები, მომსახურების პროგრამული უზრუნველყოფა, ჩიპები, მეხსიერება, ქსელი და სერვერული სისტემები ერთიან ჭრილში დააპროექტოს. რეალურ სამუშაო პროცესებზე დაკვირვებით მიღებული გამოცდილება სტეკის თითოეული შრის გაუმჯობესებას ემსახურება. Jalapeño უკვე წარმოადგენს მუშა, რეალურ პირველად პროტოტიპს გაზომვადი შედეგებით, რაც მხოლოდ მრავალთაობიანი პლატფორმის დასაწყისია. მომდევნო თვეებში კომპანია მის მასშტაბირებას გეგმავს.
როგორ იზომებოდა წარმადობა: ენერგოეფექტიანობა, როგორც ახალი სტანდარტი
OpenAI სისტემების შეფასებისას იდენტური სამომხმარებლო გამოცდილების (matched user experience) პრინციპს ეყრდნობა: იზომება, რამდენ სასარგებლო AI სამუშაოს ასრულებს სისტემა ენერგიის თითოეულ ერთეულზე ისე, რომ მომხმარებლებისა და ინტერაქციული აგენტებისთვის საჭირო დაყოვნების მკაცრი ზღვარი შეინარჩუნოს. ეს განსაკუთრებით კრიტიკულია აგენტური სისტემებისთვის, რომლებსაც თანმიმდევრულად მრავალი ნაბიჯის გადადგმა უწევთ, სადაც მცირე შეფერხებებიც კი მთელ ამოცანაზე დაგროვებითად აისახება.
პრაქტიკული შედეგების შესაფასებლად კომპანიამ გამოიყენა SemiAnalysis-ის საჯარო InferenceX, რომელიც მოთხოვნის მომსახურების სრულ ციკლს ზომავს. Jalapeño შეადარეს ბაზარზე არსებულ წამყვან კომერციულ სისტემებს სხვადასხვა რეჟიმში - მაღალი გამტარუნარიანობის სერვისიდან დაწყებული, ულტრა-დაბალი დაყოვნების ინტერაქციული გამოყენებით დამთავრებული. ინდუსტრიაში წარმადობას ხშირად ერთი ჩიპის ჭრილში აფასებენ, თუმცა OpenAI-ის პოზიციით, რეალური და ობიექტური საზომი სწორედ სიმძლავრის ერთეულზე (ვატზე) გამომუშავებული წარმადობაა.
ტესტირების შედეგებმა აჩვენა, რომ Jalapeño მნიშვნელოვნად ზრდის უპირატესობას წინა საუკეთესო TBT-თან (Time Between Tokens) შედარებით, აგენერირებს მეტ ტოკენს თითოეულ მომხმარებელზე და უზრუნველყოფს მეტ გამტარუნარიანობას ყოველ კილოვატზე. სამივე საჯარო მოდელზე ჩიპმა ვატზე წარმადობისა და დაყოვნების საუკეთესო კომბინაცია აჩვენა და ე.წ „პარეტოს ზღვარზე“ (Pareto frontier) განთავსდა. სისტემების თანმიმდევრული შედარებისთვის მონაცემები ამჩქარებლების ოფიციალურ საპასპორტო ენერგომოხმარებაზე დაკალიბრდა: Jalapeño ნომინალურად 700 ვატზეა გათვლილი, თუმცა რეალურ ტესტებში მისი უწყვეტი მოხმარება 550 ვატს ან ნაკლებს არ აღემატებოდა.
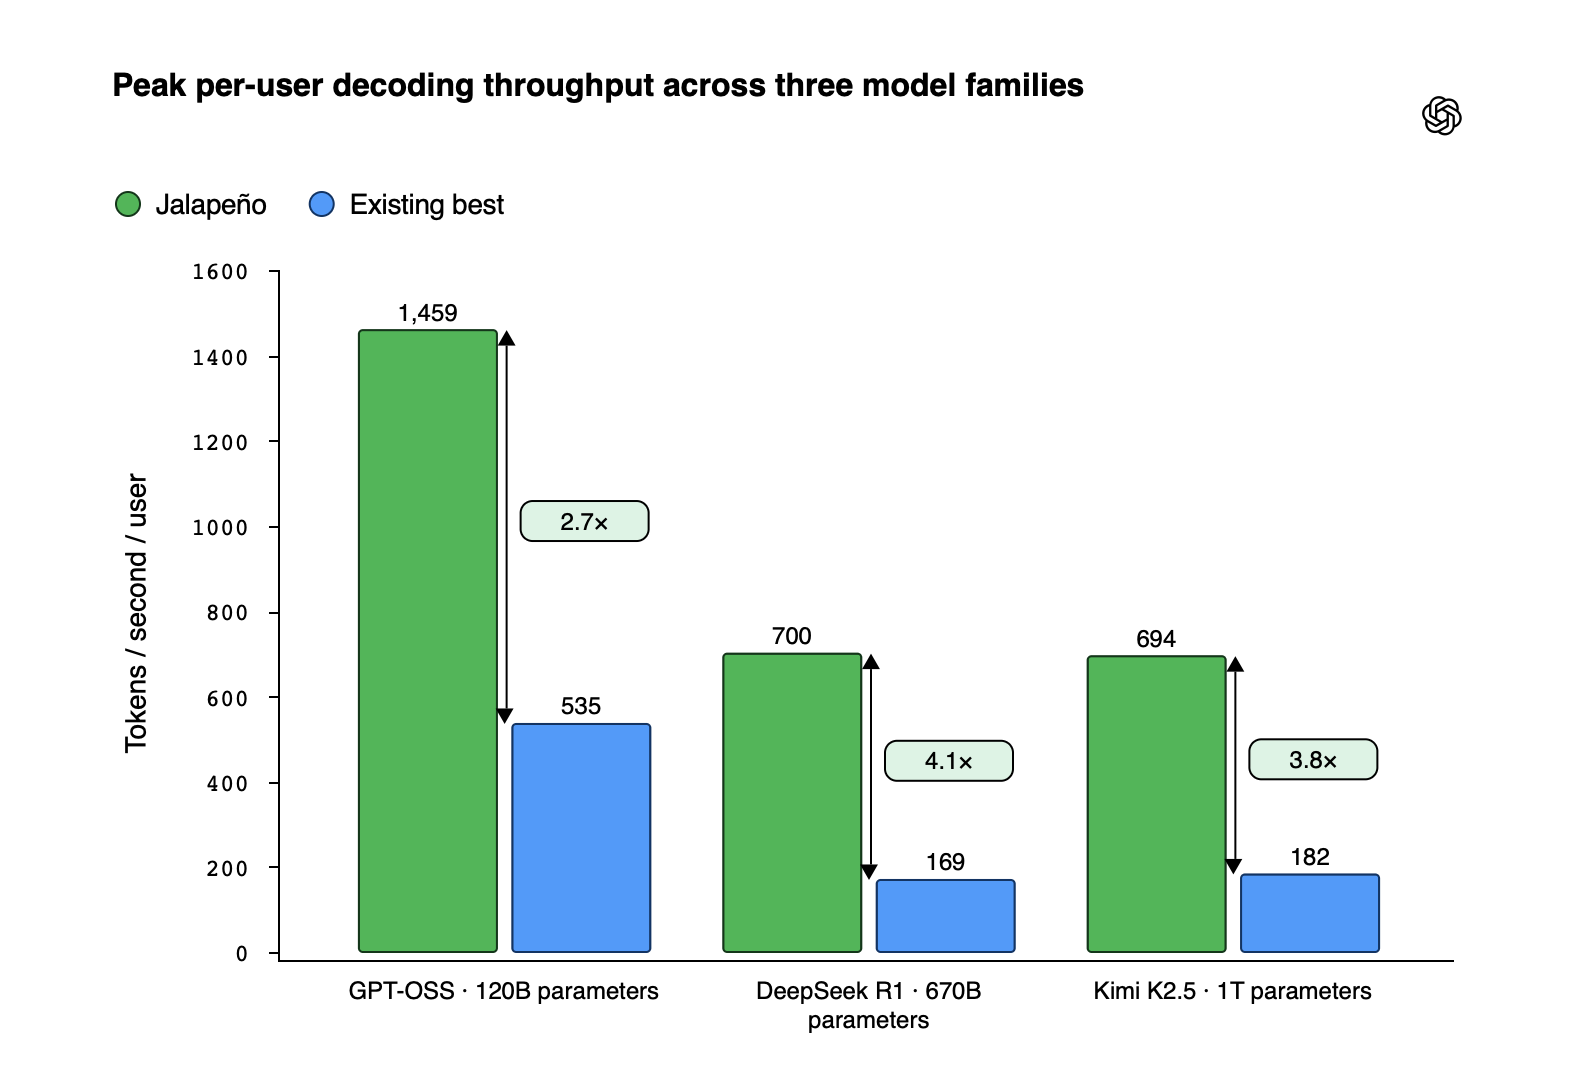
აღნიშნული უპირატესობა მკაფიოდ გამოჩნდა GPT-OSS 120B-ზე, DeepSeek R1 670B-სა და Kimi K2.5 1T-ზე. ყველაზე მასშტაბურ საჯარო მოდელზე, Kimi-ზე, Jalapeño-მ აჩვენა დაახლოებით 1.5-ჯერ მაღალი პიკური წარმადობა ვატზე და 3.4-ჯერ დაბალი სრული დაყოვნება შედარებულ სისტემასთან მიმართებით. OpenAI-ის შიდა ტესტებში ეს სხვაობა კიდევ უფრო გაიზარდა მათ წამყვან მოდელებზე, რაც მიუთითებს, რომ არქიტექტურა კიდევ უფრო ეფექტური ხდება დატვირთვისა და მოდელის მასშტაბის ზრდასთან ერთად.
არქიტექტურა სისწრაფისა და ეფექტიანობისთვის: ერთიანი ჩიპის კონცეფცია
Jalapeño-ს შექმნისას საწყისი კითხვა ასე ჟღერდა: როგორი უნდა იყოს აპარატურა, რომლის პირველადი დანიშნულება თანამედროვე და მომავალი ენობრივი მოდელების, განსაკუთრებით კი ინტერაქციული აგენტების მომსახურებაა?
ენობრივი მოდელების სწავლა/პროგნოზირება ორ მკვეთრად განსხვავებულ ფაზას გადის, რომელთაც სრულიად განსხვავებული შემაფერხებელი ფაქტორები ახასიათებთ: შევსების ფაზა (prefill), როდესაც სისტემა ამუშავებს მოთხოვნას (), მოითხოვს უდიდეს გამოთვლით სიმძლავრეს; დეკოდირების ფაზა (decode) კი, როდესაც პასუხი ტოკენ-ტოკენ გენერირდება, შეზღუდულია მეხსიერების გამტარუნარიანობით (bandwidth). გარდა ამისა, კომპონენტებსა და ჩიპებს შორის მონაცემთა მიმოცვლა აჩენს დამატებით დაყოვნებას, რა დროსაც ბირთვების ნაწილი მონაცემების მოლოდინში უმოქმედოდაა. სისტემამ, რომელიც ბრწყინვალეა ერთ ფაზაში, შესაძლოა მთლიანად დაკარგოს ეს უპირატესობა რესურსებს შორის მონაცემთა გადაადგილების გამო.
Jalapeño სწორედ იმისთვის დაპროექტდა, რომ მონაცემთა გადაადგილება და კომუნიკაციის შეფერხებები მინიმუმამდე დაეყვანა. მოდელის მდგომარეობა, მათ შორის პასუხის გენერირებისას გამოყენებული KV cache, ლოკალურად ინახება, სანამ სისტემა ინფერენსის თითოეული ფაზისთვის გამოთვლითი რესურსის, მეხსიერებისა და ქსელის ოპტიმალურ კომბინაციას ააქტიურებს. ქსელური ინფრასტრუქტურა არქიტექტურის განუყოფელი ნაწილია: მისი მასშტაბური დომენი მთელ სამუშაო დატვირთვას ერთ დაკავშირებულ სისტემაში ინარჩუნებს. შედეგად მიიღება დაბალანსებული და მოქნილი ამჩქარებელი, რომელიც ერთნაირად ეფექტურია როგორც prefill, ისე decode ეტაპზე და მარტივად ეგუება აგენტური სამუშაოების ცვალებად ბუნებას.
ხელოვნური ინტელექტი, რომელმაც შექმნა ჩიპი — და ჩიპი, რომელიც AI-სთვის დაპროგრამდა
პროექტის ერთ-ერთი ყველაზე შთამბეჭდავი ასპექტი თავად შექმნის მეთოდოლოგიაა. AI-იმ პირდაპირი როლი ითამაშა Jalapeño-ს განვითარებაში: საწყისი დიზაინიდან საწარმოო ფაზამდე (tapeout) მისვლას სულ რაღაც ცხრა თვე დასჭირდა. ალგორითმები ამოკლებდნენ დაპროექტების, გაზომვისა და ვერიფიკაციის ციკლებს, ოპტიმიზაციას უკეთებდნენ არითმეტიკულ სქემებს და გუნდს საშუალებას აძლევდნენ, დათქმულ ვადებში ჩიპში მაქსიმალური გამოთვლითი სიმძლავრე ჩაეტიათ.
ამასთანავე, Jalapeño შეიქმნა როგორც მკაფიო და პროგნოზირებადი სამიზნე პროგრამირებისთვის — როგორც ადამიანებისთვის, ისე ხელოვნური ინტელექტისთვის. ინჟინრებს შეუძლიათ აღწერონ სამუშაო ლოკალური ტენზორების, პირდაპირი კომუნიკაციისა და სინქრონიზაციის გზით, ხოლო AI-ს შეუძლია ოპტიმიზაცია გაუწიოს ამ პროცესების განაწილებას, განრიგსა და კოორდინაციას სისტემაში. ეს სტრუქტურა ხელოვნურ ინტელექტს პარალელური პროგრამირების ურთულესი ამოცანების გადაჭრის ეფექტურ ინსტრუმენტს აძლევს.
ახალი მოდელების ინტეგრაცია კვლავ მოითხოვს ახალ ბირთვებსა (kernels) და სპეციფიკურ ოპტიმიზაციას. თუმცა, Codex-ისა და GPT-Astra-ს დახმარებით, OpenAI-ის გუნდმა ორ თვეში უმაღლეს წარმადობაზე გაიყვანა ღია წონის სამი , რომლებიც თავდაპირველ საწარმოო გეგმაში საერთოდ არ შედიოდა. უფრო მეტიც: GPT-OSS-ის კონკრეტული ყურადღების () და Mixture-of-Experts (MoE) ბლოკებისთვის, AI-ის მიერ დაგენერირებულმა იმპლემენტაციებმა 1.5-დან 1.8-ჯერ უფრო სწრაფად იმუშავა, ვიდრე ადამიან ექსპერტთა მიერ დაწერილმა კოდმა. მართალია, ეს რიცხვები კონკრეტულ ბლოკებს ეხება და არა სრულ მოდელს, მაგრამ ცხადყოფს განვითარების ახალ, თვითგანმაახლებელ ციკლს.
მომავლის პერსპექტივა და ბაზრის რეალობა
AI ინფრასტრუქტურის რეალური ღირებულება იმაშია, თუ რამდენად სასარგებლო საქმის კეთება შეუძლია მას რეალურ სამყაროში. იგივე ენერგიითა და აპარატურით მეტი სამუშაოს შესრულებით, Jalapeño OpenAI-ს საშუალებას აძლევს დააკმაყოფილოს მზარდი მოთხოვნა და მკვეთრად შეამციროს თითოეული მოთხოვნის მომსახურების თვითღირებულება. კომპანიისთვის ეს ნიშნავს საოპერაციო ბერკეტის გაუმჯობესებას - შემოსავლები და შესრულებული სამუშაო გაცილებით სწრაფად იზრდება, ვიდრე სერვერული ხარჯები. ეს კი, თავის მხრივ, ხელს უწყობს ტექნოლოგიის უფრო ფართო ადაპტაციას და ინვესტიციების გაგრძელებას უკეთეს მოდელებსა და პროდუქტებში.
ტექნიკურ დონეზე, Jalapeño ცვლის ეფექტიანი და დაბალი დაყოვნების ინფერენსის შესაძლებლობებს: ის უზრუნველყოფს ულტრა-სწრაფი რეჟიმის (ultra-fast mode) ინფერენსს იმ ეფექტიანობით, რაც მანამდე მხოლოდ სწრაფ რეჟიმში იყო ხელმისაწვდომი; სწრაფი რეჟიმის (fast mode) ინფერენსს პაკეტური რეჟიმის (batched mode) ეფექტიანობით; და კიდევ უფრო მაღალ ეფექტიანობას თავად პაკეტური რეჟიმისთვის.
OpenAI გეგმავს, რომ Jalapeño-ს საკუთარ გამოთვლით ინფრასტრუქტურაში დანერგვა წლის ბოლომდე დაიწყოს. ეს მხოლოდ პირველი ნაბიჯია მრავალთაობიან საგზაო რუკაზე: მეორე თაობა (Gen 2) აქტიური განვითარების პროცესშია, ხოლო მესამე თაობა (Gen 3) უკვე იღებს საწყის ფორმას. თითოეული მათგანი მიღებულ გამოცდილებას დაეყრდნობა და კიდევ უფრო გაზრდის სისწრაფესა და ეფექტიანობას.
ამავდროულად, კომპანიაში აღიარებენ, რომ მზარდი გლობალური მოთხოვნის დაკმაყოფილება ყველა შესაძლო წყაროდან მოითხოვს გამოთვლით სიმძლავრეებს. შესაბამისად, OpenAI გააგრძელებს NVIDIA-სა და სხვა პარტნიორების ამჩქარებლების ფართომასშტაბიან გამოყენებას როგორც მოდელების წვრთნის, ისე ინფერენსის დავალებებისთვის. სანამ ჩიპის მასობრივი დანერგვა დაიწყება, გრძელდება წარმოების კვალიფიკაცია, პროგრამული უზრუნველყოფის დახვეწა და წარმადობის ვალიდაცია მოდელების ფართო სპექტრზე, რაც კიდევ ერთხელ ადასტურებს, თუ რა შედეგის მოტანა შეუძლია პროგრამული და აპარატურული სისტემების ერთიან, ჰარმონიულ დაპროექტებას.
ეს უბრალოდ AI-ია. გაუზიარე სტატია მეგობარს და დაგვეხმარე, უფრო მეტი ადამიანი გავხადოთ ინფორმირებული AI-ის შესახებ.